
Bir web sitesinin hangi bölümlerinin arama motoru botları tarafından taranıp hangilerinin taranmaması gerektiğini belirlemenin standart yolu robots.txt dosyasıdır. Doğru yapılandırılmadığında, sitenizin önemli sayfalarının taranmasını yanlışlıkla engelleyebilir veya tam tersine, gizli kalması gereken bölümleri açıkta bırakabilirsiniz.
Bu yazıda robots.txt’nin ne olduğunu, nasıl çalıştığını, hangi komutları içerdiğini, nasıl oluşturulup test edildiğini ve kullanırken sık yapılan hataları adım adım ele alıyorum. Ayrıca Disallow ile noindex arasındaki kritik farkı da açıklığa kavuşturuyorum, çünkü bu iki kavramın karıştırılması sitelerde en sık rastlanan teknik SEO hatalarından biridir.
Robots.txt Nedir?
Robots.txt, bir web sitesinin kök dizininde yer alan, arama motoru botlarına sitenin hangi bölümlerini tarayıp hangilerini taramaması gerektiğini bildiren basit bir metin dosyasıdır. Teknik olarak bir “Robots Exclusion Protocol” (Robot Hariç Tutma Protokolü) standardıdır ve sitenize gelen her botun, taramaya başlamadan önce bu dosyaya bakması beklenir. Bu standart, 1994 yılından beri web’de kullanılan, oldukça eski ama hâlâ geçerliliğini koruyan bir protokoldür.
Robots.txt Dosyası Nerede Bulunur?
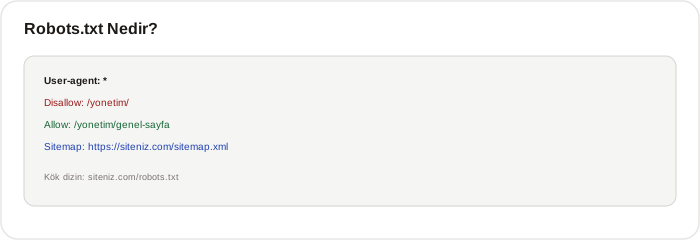
Robots.txt dosyası her zaman sitenin kök dizininde, siteniz.com/robots.txt adresinde yer almalıdır. Başka bir klasörde veya alt dizinde konumlandırılan bir robots.txt dosyası, arama motorları tarafından geçersiz sayılır ve hiçbir etkisi olmaz.
Dosya içeriği oldukça basittir: her kural bloğu bir User-agent satırıyla başlar, ardından o bot için geçerli olan Disallow ve Allow satırları gelir. Örneğin basit bir blok şu şekilde görünebilir: User-agent: * ve altında Disallow: /yonetim/ — bu, tüm botların /yonetim/ klasörünü taramasını engeller.
Robots.txt Nasıl Çalışır?
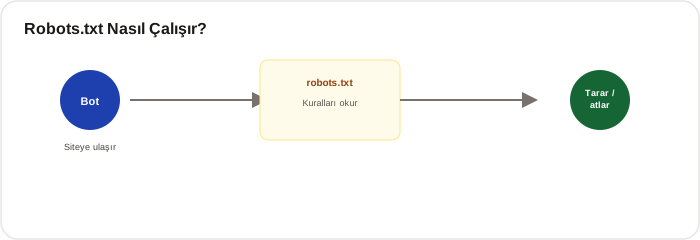
Bir arama motoru botu sitenize ulaştığında, önce robots.txt dosyasını okur ve bu dosyadaki kurallara göre hangi URL’leri tarayıp hangilerini atlayacağına karar verir. Bu, bir “izin listesi” değil, bir “yönlendirme” mekanizmasıdır — yani dosyadaki kurallar botlara ne yapmaları gerektiğini önerir, ama bunu zorla uygulamaz.
Her Arama Motoru Robots.txt’ye Uyar mı?
Google, Bing gibi saygın arama motorları robots.txt kurallarına genellikle uyar. Ancak kötü niyetli botlar veya bazı küçük tarayıcılar bu dosyayı tamamen görmezden gelebilir; bu nedenle robots.txt, hassas veya gizli bilgileri korumak için güvenlik önlemi olarak kullanılmamalıdır.
Robots.txt ayrıca “tarama bütçesi” (crawl budget) yönetiminde de rol oynar. Özellikle çok sayfalı büyük sitelerde, Googlebot’un zamanını önemsiz, tekrarlayan veya düşük değerli sayfalarda (filtre parametreli URL’ler gibi) harcamasını önleyerek, botun zamanını daha değerli sayfalara yönlendirmesine yardımcı olabilir.
Robots.txt Dosyasında Hangi Komutlar Kullanılır?
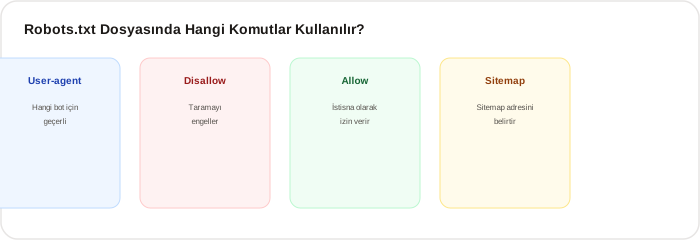
Robots.txt dosyasında en sık kullanılan dört komut şunlardır: User-agent hangi bot için kuralın geçerli olduğunu belirtir (örneğin Googlebot veya tüm botlar için *), Disallow botun taramaması gereken yolu belirtir, Allow genel bir Disallow kuralı içinde belirli bir alt yolun taranmasına izin verir ve Sitemap ise sitenizin sitemap.xml adresini belirterek botların bu dosyayı daha kolay bulmasını sağlar.
Disallow ve Allow Farkı Nedir?
Disallow, belirtilen bir yolun taranmasını tamamen engeller; Allow ise genellikle daha geniş bir Disallow kuralı içinde, belirli bir alt klasör veya dosyanın istisna olarak taranmasına izin vermek için kullanılır. Örneğin /yonetim/ klasörünü kapatıp içindeki tek bir genel sayfayı Allow ile açabilirsiniz.
Birden fazla User-agent bloğu da tanımlanabilir; bu sayede farklı botlara farklı kurallar uygulanabilir. Örneğin genel botlar için bir bölümü kapatırken, belirli bir bota (örneğin bir görsel arama botuna) farklı bir kural seti tanımlayabilirsiniz. Satır başına yalnızca bir komut yazılması ve yolların mutlaka / ile başlaması, dosyanın doğru yorumlanması için önemlidir.
Robots.txt Nasıl Oluşturulur?
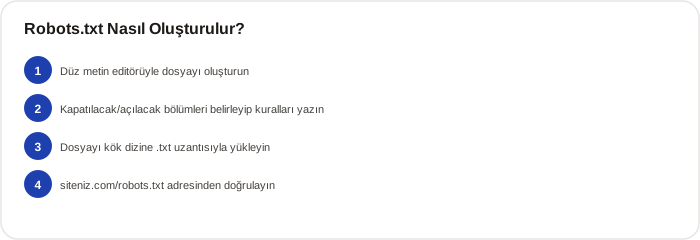
Robots.txt dosyası, düz metin editörüyle kolayca oluşturulabilen basit bir dosyadır. Dosyayı oluşturduktan sonra, sitenizin kök dizinine .txt uzantısıyla yüklemeniz yeterlidir. Modern web teknolojileriyle kodlanmış sitelerde bu dosya genellikle statik bir dosya olarak proje içine eklenir ve build sürecinde otomatik olarak yayınlanır.
WordPress’te Robots.txt Nasıl Düzenlenir?
WordPress, kendi başına “sanal” bir robots.txt dosyası üretir; ancak Yoast SEO veya Rank Math gibi SEO eklentileri üzerinden bu dosyanın içeriğini doğrudan panel üzerinden düzenleyebilirsiniz. Eklenti kullanmıyorsanız, dosyayı FTP ile sitenizin kök dizinine manuel olarak da yükleyebilirsiniz.
Hangi platformu kullanırsanız kullanın, robots.txt’nin içeriğini belirlemeden önce sitenizdeki hangi bölümlerin gerçekten gizlenmesi gerektiğini netleştirmek önemlidir: yönetim paneli, arama sonucu sayfaları, test ortamları veya filtrelenmiş ürün listeleme sayfaları genellikle bu kapsama girer.
Robots.txt Test Etme ve Kontrol Yöntemleri
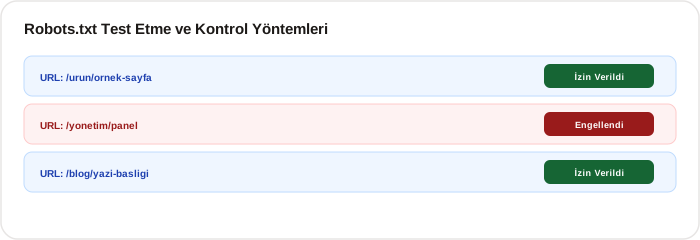
Robots.txt dosyanızı yayınladıktan sonra, kuralların beklediğiniz gibi çalıştığını doğrulamak kritik önem taşır. Google Search Console üzerindeki araçlar veya bağımsız robots.txt test araçları, belirli bir URL’nin taranıp taranamayacağını anında gösterir.
Test ederken sadece ana sayfayı değil, kapatmak istediğiniz ve açık bırakmak istediğiniz birkaç farklı örnek URL’yi de kontrol etmek önemlidir; çünkü kurallar birbirini etkileyebilir ve beklenmedik bir şekilde doğru sayfayı da kapsam dışına alabilir.
Robots.txt Hatalarını Nasıl Anlarım?
Bir sayfanızın Google’da beklenenden az göründüğünü veya hiç dizine eklenmediğini fark ederseniz, önce robots.txt dosyanızı kontrol edin; yanlışlıkla eklenmiş bir Disallow kuralı, o sayfanın hiç taranmamasına neden olabilir. Search Console’daki “Dizine Eklenmedi” raporu, bu tür engellenmiş sayfaları açıkça listeler.
Robots.txt Kullanırken Yapılan Yaygın Hatalar
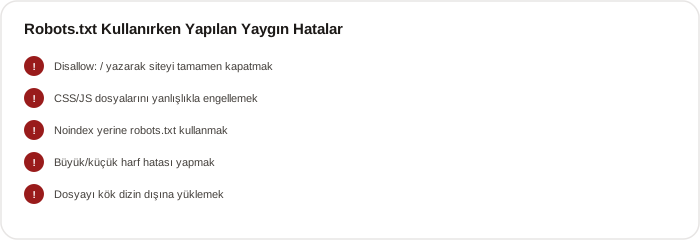
Robots.txt basit görünse de, küçük bir yazım hatası sitenizin görünürlüğünü önemli ölçüde etkileyebilir. Dosyayı değiştirmeden önce mevcut haliyle bir yedek almak ve her değişiklikten sonra test aracıyla doğrulamak, bu hataların çoğunu baştan önler.
Yanlış Bir Disallow Kuralı Sitemi Nasıl Etkiler?
En sık rastlanan hata, yanlışlıkla Disallow: / yazarak sitenin tamamını taramaya kapatmaktır; bu tek satır, sitenizin tüm sayfalarının arama motorlarından tamamen kaybolmasına yol açabilir. Bu nedenle robots.txt’de yapılan her değişikliği yayınlamadan önce bir test aracıyla doğrulamak çok önemlidir.
- Siteyi yanlışlıkla tamamen kapatmak:
Disallow: /satırı, sitenizin tüm sayfalarının taranmasını engeller. - CSS/JS dosyalarını engellemek: Google’ın sayfanızı doğru render edebilmesi için stil ve betik dosyalarına erişebilmesi gerekir; bunları engellemek görünüm sorunlarına yol açabilir.
- Robots.txt’yi noindex yerine kullanmak: Bir sayfanın aramada görünmesini tamamen engellemek istiyorsanız robots.txt yeterli değildir;
noindexmeta etiketi kullanılmalıdır, çünkü taranması engellenen bir sayfa yine de başka kaynaklardan bağlantı alırsa dizine eklenebilir. - Büyük/küçük harf hatası yapmak: Robots.txt kuralları büyük/küçük harfe duyarlıdır;
/Resimler/ile/resimler/farklı yollar olarak değerlendirilir. - Dosyayı yanlış konuma yüklemek: Kök dizin dışında herhangi bir yere yüklenen robots.txt dosyası, arama motorları tarafından tamamen görmezden gelinir.
Sıkça Sorulan Sorular
01Robots.txt nedir?
Robots.txt, bir sitenin kök dizininde yer alan ve arama motoru botlarına hangi bölümlerin taranıp hangilerinin taranmaması gerektiğini bildiren bir metin dosyasıdır.
02Robots.txt zorunlu mu?
Hayır, zorunlu değildir; robots.txt olmayan bir sitede botlar varsayılan olarak her şeyi taramaya çalışır. Ancak belirli bölümleri kontrol etmek isteyen siteler için faydalı bir araçtır.
03Robots.txt bir sayfayı Google’dan tamamen kaldırır mı?
Hayır; robots.txt sadece taramayı engeller, daha önce dizine eklenmiş bir sayfayı aramadan kaldırmaz. Bir sayfayı tamamen kaldırmak için noindex etiketi veya Search Console’daki kaldırma aracı kullanılmalıdır.
04Robots.txt dosyası nasıl test edilir?
Google Search Console’daki araçlar veya bağımsız robots.txt test araçları ile belirli bir URL’nin taranıp taranamayacağı anında kontrol edilebilir.
05Disallow ve noindex arasındaki fark nedir?
Disallow, bir sayfanın taranmasını engeller; noindex ise sayfanın taranmasına izin verir ama arama sonuçlarında gösterilmemesini sağlar. İkisi farklı amaçlara hizmet eder ve genellikle birlikte kullanılmamalıdır.
06Her site için robots.txt gerekli mi?
Küçük, basit sitelerde robots.txt olmasa da sorun yaşanmaz; ancak yönetim panelleri, arama sonucu sayfaları gibi gizlenmesi gereken bölümleri olan siteler için önerilir.
07Robots.txt dosyasında yorum satırı nasıl eklenir?
Satırın başına # işareti koyarak yorum ekleyebilirsiniz; bu satırlar botlar tarafından okunmaz, sadece dosyayı düzenleyenler için açıklama amaçlıdır.
08Robots.txt ile belirli bir bot engellenebilir mi?
Evet; User-agent satırına ilgili botun adını yazıp Disallow: / ekleyerek yalnızca o botu tüm siteden men edebilirsiniz.
09Robots.txt dosyasını değiştirdikten sonra etkisi ne kadar sürede görülür?
Bu, botların sitenizi ne sıklıkla taradığına bağlıdır; genellikle birkaç gün içinde yeni kurallar fark edilir, ancak hızlandırmak için Search Console üzerinden yeniden tarama talep edilebilir.
10Robots.txt dosyası SEO sıralamasını doğrudan etkiler mi?
Doğrudan bir sıralama faktörü değildir, ancak yanlış yapılandırıldığında önemli sayfaların taranmasını engelleyerek dolaylı olarak sıralamayı olumsuz etkileyebilir.
11Robots.txt dosyasında kaç User-agent bloğu olabilir?
Sınır yoktur; farklı botlara farklı davranış tanımlamak istiyorsanız, dosya içinde birden fazla User-agent bloğu art arda tanımlayabilirsiniz.
12Crawl budget (tarama bütçesi) ile robots.txt’nin ilişkisi nedir?
Robots.txt, önemsiz veya tekrarlayan sayfaları taramaya kapatarak Googlebot’un zamanını daha değerli sayfalara ayırmasına yardımcı olabilir; bu da özellikle büyük sitelerde tarama bütçesinin verimli kullanılmasını sağlar.
13Robots.txt dosyası olmadan site taranabilir mi?
Evet; robots.txt dosyası bulunmayan bir sitede botlar varsayılan olarak tüm sayfaları taramaya çalışır, herhangi bir kısıtlama uygulanmaz.
14Robots.txt’de wildcard (joker karakter) kullanılabilir mi?
Evet; * karakteri herhangi bir karakter dizisini, $ ise URL’nin bittiği noktayı temsil eder. Bu sayede /*.pdf$ gibi bir kuralla, tüm PDF dosyalarını tek satırda kapatabilirsiniz.
15Robots.txt dosyasını kim yönetmeli, geliştirici mi SEO uzmanı mı?
İkisinin de dahil olması idealdir; SEO uzmanı hangi bölümlerin kapatılması gerektiğine karar verirken, geliştirici bu kuralların teknik olarak doğru ve güvenli şekilde uygulanmasını sağlar.
İlgili
Robots.txt ile birlikte kullanılan Sitemap.xml Nedir, Nasıl Oluşturulur? ve Googlebot Nedir? yazılarımızı, teknik SEO temelleri için Teknik SEO Rehberi sayfamızı inceleyebilirsiniz.
İlgili Araç
Kendi robots.txt dosyanızı hazırlamak veya mevcut dosyanızı test etmek için Robots.txt Oluşturucu ve Robots.txt Test araçlarımızı ücretsiz kullanabilirsiniz.

